Datos y analítica
Extracción y pipelines de datos para que dejes de exportar y pegar información a mano.
Problemas que resolvemos
Tecnologías que usamos
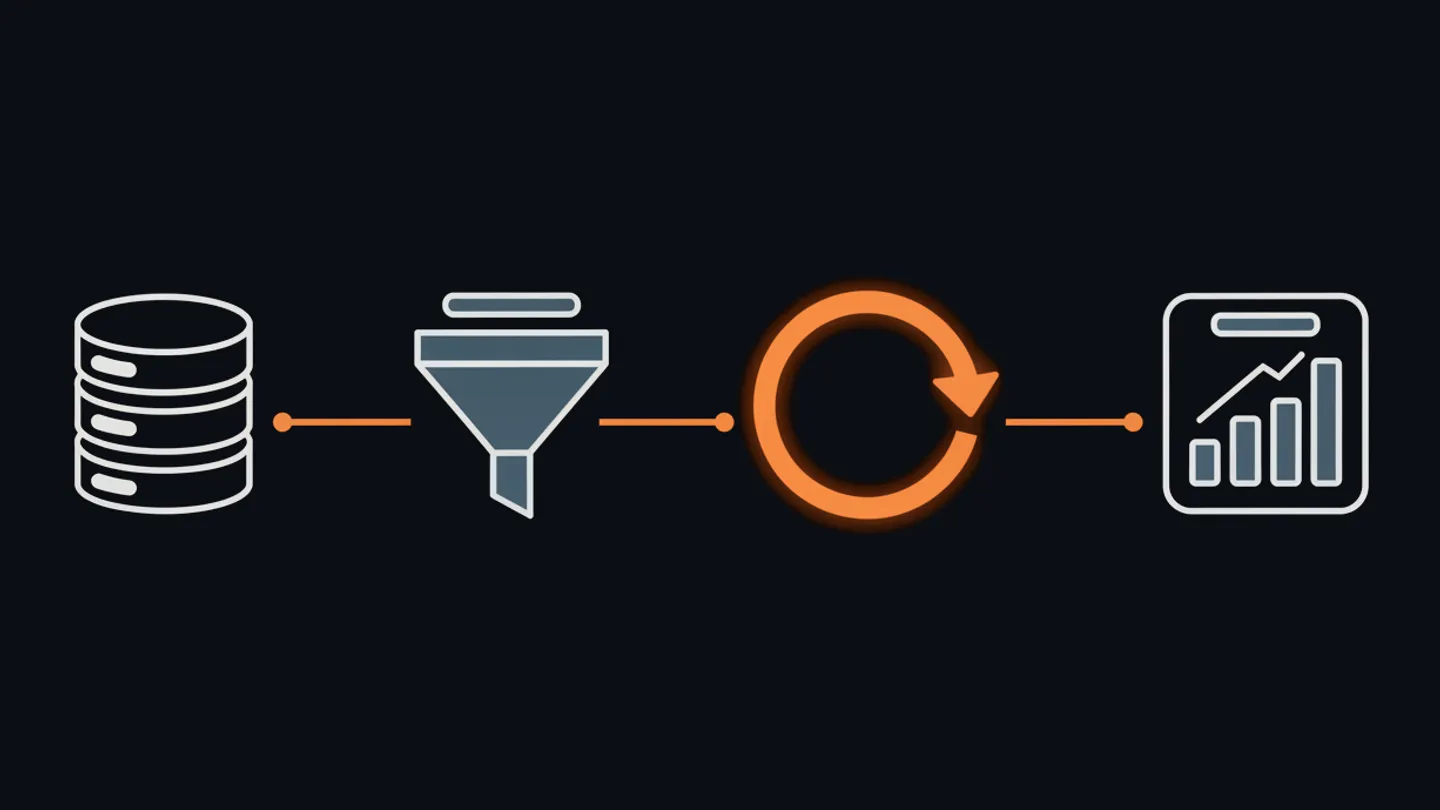
Toda empresa ya tiene datos. La pregunta no es si los tiene, sino cuánto trabajo cuesta sacarles una respuesta.
En la mayoría de las pymes esa respuesta vive al final de una cadena manual: alguien exporta de un sistema, pega en una hoja de cálculo, ajusta unas fórmulas y manda el archivo por correo. Eso ya es un proceso de datos, solo que es lento, se rompe fácil y depende de que esa persona no se equivoque ni salga de vacaciones.
Lo que hacemos es reemplazar esa cadena por una que corre sola: los datos se extraen, se limpian y se actualizan sin que nadie los toque, y el reporte deja de ser una tarea para pasar a estar simplemente ahí.
Todo lo que hacemos con datos
El recorrido completo, desde donde la información está atrapada hasta el número que alguien usa para decidir. Un proyecto rara vez necesita todas las etapas, pero casi siempre necesita más de una, y es útil saber de antemano cuáles existen.
Extracción
Sacar la información de donde vive hoy. Leemos bases de datos de los sistemas que ya usas, directamente o contra una réplica cuando conviene no cargar el sistema en producción. Consumimos APIs de tu ERP, tu tienda en línea, tu pasarela de pagos o tu plataforma de facturación. Tomamos archivos de Excel, CSV y XML desde una carpeta compartida o desde la bandeja de correo donde ya llegan.
Y cuando el sistema no ofrece ninguna salida, que pasa más seguido de lo que parece, automatizamos la extracción de forma controlada, siempre con el permiso de quien es dueño del sistema y dejando escrito qué se extrae y cada cuánto.
Minería web y de fuentes públicas
Datos que no están adentro de tu empresa pero sí afectan tus decisiones: precios de la competencia, disponibilidad de productos, tipos de cambio, licitaciones publicadas, padrones y registros públicos. Se recolectan de forma periódica y se guardan con su fecha, que es lo que convierte una consulta suelta en una serie con la que se puede comparar y ver una tendencia.
Extracción de datos desde documentos
Facturas, contratos, formularios, estados de cuenta y actas, en PDF o escaneados, de los que hay que sacar campos concretos. Se combina reconocimiento de texto con modelos de lenguaje para leer el documento y devolver los campos estructurados, con verificación humana en los casos donde el modelo no tiene confianza suficiente. Es lo que convierte una carpeta de PDF en una tabla consultable.
Migración
Mover años de historia desde sistemas viejos, hojas sueltas o archivos heredados hacia algo que sí se pueda mantener. La parte que distingue una migración bien hecha de una mala es la validación: se cuenta y se cuadra lo que salió contra lo que llegó, campo por campo y total por total, y queda un informe de diferencias antes de dar por buena la carga. Hemos migrado desde bases de datos descontinuadas, desde sistemas contables propietarios y desde estructuras de archivos que nadie había documentado.
Limpieza y calidad
Es la etapa que más tiempo consume y la que nadie cotiza. Clientes duplicados escritos de cuatro formas distintas, montos con y sin impuesto en la misma columna, fechas en tres formatos, códigos que cambiaron de criterio a mitad de camino, campos obligatorios vacíos. Se perfila el dato para saber qué tan sucio está, se escriben las reglas de normalización y deduplicación, y se dejan corriendo como parte del proceso, para que la limpieza no sea algo que alguien rehace cada mes.
Transformación y modelado
Convertir el dato crudo en algo que responda preguntas. Se unen las fuentes, se aplican las reglas de negocio y se arma un modelo pensado para consultar: tablas de hechos y dimensiones, jerarquías de producto y de cliente, calendarios fiscales. Aquí es donde queda definido de una sola vez qué cuenta como una venta, desde cuándo un cliente está activo y si el monto lleva ITBMS, que es lo que evita que dos áreas presenten cifras distintas de lo mismo.
Consolidación en una sola fuente
Una base donde la información de todos los sistemas ya está integrada y cuadrada. Es lo que permite cruzar ventas con inventario, o cobros con clientes, sin abrir tres pantallas y confiar en que los números coinciden. Sin esta etapa, cada reporte vuelve a resolver el mismo rompecabezas por su cuenta.
Almacenamiento e histórico
Dónde vive todo eso y por cuánto tiempo. Para el volumen de una pyme, una base PostgreSQL bien modelada sostiene sin problema los años de historia y los tableros. Cuando el volumen crece, se pasa a un esquema de data warehouse con el histórico particionado. La decisión que importa desde el primer día no es el motor, es guardar el dato crudo tal como llegó: es lo que permite reprocesar cuando una regla cambia, sin tener que volver a pedirle todo al origen.
Análisis y minería de datos
Lo que se hace una vez que los datos están en orden, y donde suele estar el valor que la empresa no sabía que tenía:
- Exploración y perfilado. Qué hay realmente en los datos: distribuciones, valores atípicos, huecos, relaciones que nadie había mirado.
- Segmentación. Agrupar clientes, productos o sucursales por comportamiento real y no por la categoría que alguien asignó hace años.
- Series de tiempo y pronóstico. Estacionalidad, tendencia y proyección de demanda, ventas o consumo, para planificar compras e inventario con algo más que la intuición.
- Detección de anomalías. Consumos, cobros o movimientos que se salen del patrón, que es la base de la detección temprana de fraude y de errores de captura.
- Análisis de relaciones. Cuando lo que importa no son los registros sino cómo se conectan entre sí: clientes que comparten datos de contacto, redes de proveedores, cadenas de transacciones. Se modela como grafo y se consulta como grafo.
- Análisis de canasta y comportamiento. Qué se compra junto, qué secuencia de pasos termina en una venta y en cuál se cae la gente.
Visualización y reportes
La capa que el equipo abre todos los días. Tableros con pocos números, los que se usan para decidir algo, actualizados solos. Reportes que salen por correo el día y la hora acordados, ya armados, en lugar de que alguien los prepare. Y vistas distintas según quién mire: no necesita lo mismo quien atiende una sucursal que quien revisa el consolidado.
Automatización, monitoreo y alertas
Que todo lo anterior corra sin que nadie se acuerde. El proceso se ejecuta en el horario definido, deja registro de cada corrida, y avisa cuando algo falla o cuando un indicador cruza un umbral que definiste. Una alerta útil llega antes de que el problema aparezca en el reporte de fin de mes.
Cómo se construye un pipeline en el que se puede confiar
Un proceso que trae datos es fácil. Lo difícil es que dentro de seis meses alguien siga creyendo en los números que produce. Esto es lo que lo sostiene:
- El dato crudo se guarda tal como llegó. Antes de limpiar nada se conserva la copia original. Es lo que permite reprocesar cuando una regla cambia, sin tener que volver a pedirle todo al origen.
- Cargas incrementales e idempotentes. Cada corrida trae solo lo nuevo, y correr dos veces el mismo día no duplica una sola fila. Sin esto, un reintento después de un fallo infla los totales.
- Pruebas sobre los datos, no solo sobre el código. En cada corrida se verifica lo que tiene que ser cierto: que la llave no se repita, que los campos obligatorios vengan, que los montos estén en rango y que el total cuadre contra el sistema de origen. Si algo no pasa, la corrida se detiene en vez de publicar un número malo.
- Cada indicador definido una sola vez. Esa lógica vive en el modelo y no dentro de cada reporte, que es como dos áreas terminan presentando cifras distintas de lo mismo.
- Trazabilidad. De cada número del tablero se puede llegar hasta la fila del sistema de origen que lo produjo. Es lo que convierte una discusión sobre si el dato está bien en una revisión de treinta segundos.
- Frescura vigilada. Si el pipeline no corrió, o corrió y trajo la mitad, avisa. Un tablero desactualizado sin aviso es peor que no tener tablero, porque se decide igual sobre él.
Con qué lo hacemos
Python con Pandas para la extracción y la transformación, SQL y dbt para modelar y probar, y Airflow cuando la orquestación lo amerita. Los datos, en PostgreSQL, MySQL o SQL Server, y motores como MongoDB o ArangoDB cuando el problema es de documentos o de relaciones. Para la visualización, Power BI, Metabase o Looker Studio, según lo que tu equipo ya use y pueda mantener.
No vendemos licencias de ninguna de esas herramientas, así que la recomendación no depende de cuál nos conviene.
Qué recibes al final
La base con los datos ya integrados y limpios. El tablero funcionando, con acceso para quien lo necesite. El código del pipeline en un repositorio tuyo, con sus pruebas. Y el diccionario de indicadores: qué significa exactamente cada número, de dónde sale y cada cuánto se actualiza, que es el documento que evita la discusión de “a mí me da distinto”.
Cómo trabajamos esto
Empezamos por una sola pregunta de negocio, no por conectar todo. Un primer tablero útil, con los datos que ya se pueden traer, suele estar en 2 o 3 semanas, y a partir de ahí se agregan fuentes con el proceso ya andando. Es más barato y se corrige antes que un proyecto de seis meses que se ve completo solo el último día.
El alcance va escrito y con precio fijo antes de empezar, igual que en el resto de lo que hacemos.
Problemas que resolvemos
Casos reales y problemas concretos de esta área.
- Proyecto
¿Cómo funciona un grafo de detección de fraude en seguros?
Por qué las reglas simples y la revisión manual no alcanzan para detectar fraude en reclamos, y cómo un grafo de entidades expone lo que antes era invisible.
Leer → - ProyectoSector legal, Panamá
Extracción de entidades sobre texto legal panameño
Cómo se construyó un reconocedor de entidades afinado sobre el estilo de redacción legal panameño, para un despacho que revisaba leyes y expedientes a mano.
Leer → ¿Qué es un pipeline de datos y por qué importa para tu negocio?
Una explicación sin jerga de qué hace un pipeline de datos, y por qué reemplaza los reportes armados a mano cada mes.
Leer →Cada mes alguien arma el mismo reporte a mano.
Automatizamos la cadena completa: extracción, limpieza y cálculo corriendo solos, en el horario que definas. El reporte pasa de ser una tarea de dos días a estar listo antes de que alguien lo pida.
Artículo en preparaciónCada área da un número distinto para lo mismo.
Ventas dice una cosa, contabilidad otra, y la reunión se va en discutir cuál está bien. Consolidamos las fuentes en un solo lugar, con las reglas de cálculo escritas una sola vez, para que todos miren el mismo número y la discusión pase a ser sobre qué hacer.
Artículo en preparación- Caso real
La información está regada en veinte hojas de cálculo.
Migramos y consolidamos datos dispersos a una base de datos real, con limpieza y validación de integridad. Hemos trabajado con MySQL, PostgreSQL, SQL Server, ArangoDB y SQLite, entre otras.
Artículo en preparación Tengo los datos, pero no me dicen nada.
Reportes y dashboards alimentados por un pipeline de verdad, no por exports manuales: ventas por producto, margen por cliente, rotación de inventario. Lo que necesites mirar para decidir, actualizándose solo.
Artículo en preparación- Caso real
Transcribimos facturas y recibos a mano.
Extracción automática de datos desde documentos (facturas, contratos, PDFs escaneados) para que dejen de teclearse uno por uno. Tenemos dbt corriendo en producción para la agregación de facturas electrónicas.
Artículo en preparación El sistema que uso no me deja exportar lo que necesito.
Sacamos los datos igual: directo de la base de datos, por API, o desde donde estén (ERP, CRM, POS). Que una pantalla no tenga botón de exportar no significa que la información no esté ahí.
Artículo en preparación- Caso real
Necesito vigilar información que está en la web.
Scraping y monitoreo automatizado de fuentes públicas, con alertas cuando algo cambia. Lo hemos hecho en producción para Alertar.me.
Artículo en preparación Vamos a cambiar de sistema y hay que mover todo.
Migraciones con validación: no solo copiar los datos, sino verificar que lo que llegó es lo que salió, cuadrar totales y dejar registro de lo que se transformó en el camino.
Artículo en preparaciónLos datos están sucios y nadie confía en ellos.
Nombres duplicados, fechas en tres formatos, campos vacíos, el mismo cliente escrito de cuatro maneras. Limpieza, normalización y reglas de validación que se ejecutan siempre, no una sola vez.
Artículo en preparación- Caso real
Necesito leer documentos largos y encontrar lo que importa.
Extracción de entidades e información específica sobre grandes volúmenes de texto. El caso ancla de esta área es un sistema de extracción sobre texto legal panameño con 92% de precisión.
Artículo en preparaciónLeer →
Preguntas frecuentes sobre esta área
Si tu pregunta no está aquí, escríbenos por WhatsApp y te respondemos directo.
¿Tengo que comprar un data warehouse o una herramienta cara?
Casi nunca al principio. Para el volumen de una pyme, una base PostgreSQL bien modelada sostiene sin problema los años de historia y los tableros, y no cuesta licencia. Si el volumen o la concurrencia llegan a justificar algo más grande, el pipeline ya está escrito en código y se mueve; empezar por la herramienta cara es pagar por adelantado un problema que puede no llegar.
Mis datos están sucios y no cuadran entre sistemas. ¿Eso es un problema para empezar?
No, es el trabajo. Prácticamente ningún proyecto empieza con datos limpios: hay clientes duplicados, montos con y sin impuesto, fechas en tres formatos y códigos que cambiaron de criterio en el camino. Parte de lo que se entrega es justamente el proceso que detecta eso, lo deja registrado y lo corrige de forma repetible, en vez de que alguien lo arregle a mano cada mes.
El sistema que uso no tiene forma de exportar. ¿Se puede sacar la información igual?
En general sí, y hay varios caminos: leer su base de datos directamente, usar una API que muchas veces existe aunque no esté documentada, o automatizar la extracción de forma controlada. Lo que sí hacemos siempre es hacerlo con el permiso de quien es dueño del sistema, y dejando claro qué se extrae y con qué frecuencia.
¿Power BI, Metabase o Looker Studio?
Depende de lo que tu equipo ya use y pueda mantener, y de si necesitas control de acceso por usuario. No vendemos licencias de ninguna, así que la recomendación no depende de cuál nos conviene. Lo que no cambia con la herramienta es la capa de abajo: si el pipeline está bien hecho, cambiar de tablero después es un trabajo de días.
¿Cada cuánto se actualizan los datos?
Lo que haga falta para la decisión que se toma con ellos. Para la mayoría de los tableros de gestión, una actualización diaria de madrugada alcanza y es la más barata de sostener. Cuando el caso lo pide se baja a cada hora o a casi tiempo real, pero eso encarece la operación, así que conviene justificarlo y no pedirlo por defecto.
¿Qué pasa si el proceso falla un día y el tablero queda viejo?
Avisa. Cada corrida se registra y se vigila la frescura de los datos, así que una falla genera alerta en vez de pasar desapercibida. Eso importa más de lo que parece: un tablero desactualizado sin aviso es peor que no tener tablero, porque el equipo decide igual sobre él creyendo que está al día.
¿Esto es lo que necesitas?
Cuéntanos tu caso y te decimos si tiene sentido trabajar juntos - sin costo ni compromiso.
Hablar por WhatsApp